Найменше топологічне сортування#10651

Послідовність a = (a_1, a_2, ..., a_n) лексикографічно менша за послідовність b = (b_1, b_2, ..., b_n), якщо на першій позиції , де вони відрізняються, виконується a_i < b_i. Таким чином, щоб отримати лексикографічно найменшу топологічну сортування, на перше місце потрібно поставити найменшу можливу вершину, на друге — найменшу з можливих при вже вибраній першій, і так далі.
Для розв'язання задачі скористаємося алгоритмом Кана. (Kahn). Для кожної вершини обчислимо її вхідний степінь — кількість ребер, що входять до неї. Вершина може стояти на черговому місці в топологічній сортуванні тоді й лише тоді, коли всі її попередники вже виписані, тобто її поточний вхідний степінь дорівнює нулю.
У класичному алгоритмі Кана вершини з нульовим вхідним степенем зберігаються у звичайній черзі та витягуються в довільному порядку. Щоб отримати лексикографічно найменшу відповідь, замінимо чергу на чергу з пріоритетом (або множину set), з якої щоразу витягується вершина з найменшим номером.
Алгоритм виглядає наступним чином:
обчислюємо вхідні степені всіх вершин;
поміщаємо в чергу з пріоритетом усі вершини з нульовим вхідним степенем — саме вони можуть починати топологічну сортування;
поки черга не порожня, витягуємо з неї вершину з найменшим номером і додаємо її до відповіді. Потім для кожного ребра v \to u зменшуємо вхідний степінь вершини на . Якщо він став рівним нулю, додаємо до черги.
Виявлення циклу. Якщо граф містить цикл, то жодна з вершин циклу ніколи не отримає нульовий вхідний степінь і не потрапить до черги. Тому, якщо по завершенні алгоритму до відповіді потрапило менше n вершин, топологічна сортування неможлива — виводимо .
Складність. Кожна вершина додається до черги з пріоритетом і витягується з неї рівно один раз, кожне ребро переглядається один раз. Час роботи становить O(n~log~n + m).
Приклад
Граф, наведений у прикладі, має наступний вигляд:
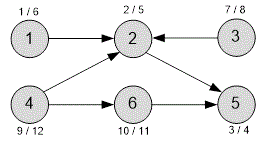
Даний граф допускає кілька варіантів топологічної сортування. Наприклад:
1, 4, 6, 3, 2, 5;
4, 3, 6, 1, 2, 5;
3, 1, 4, 2, 6, 5;
Лексикографічно найменшою топологічною сортуванням є
Лексикографічно найбільшою топологічною сортуванням є
Реалізація алгоритму — set
Вхідний граф зберігаємо у вигляді списку суміжності . Вхідні степені вершин зберігаємо в масиві InDegree. Топологічно відсортовані вершини графа заносимо в масив .
vector<vector<int> > g;
vector<int> InDegree, Order;
set<int> minHeap;
Читаємо вхідний граф.
scanf("%d %d", &n, &m);
g.resize(n + 1);
InDegree.resize(n + 1);
Обчислюємо вхідні степені для всіх вершин. Для кожного ребра збільшуємо значення вхідного степеня вершини .
for (i = 0; i < m; i++)
{
  scanf("%d %d", &a, &b);
  g[a].push_back(b);
  InDegree[b]++;
}
Усі вершини з нульовим вхідним степенем додаємо до множини .
for (i = 1; i < InDegree.size(); i++)
  if (InDegree[i] == 0) minHeap.insert(i);
Продовжуємо роботу алгоритму топологічної сортування, поки множина не стане порожньою.
while (!minHeap.empty())
{
Витягуємо з вершину з найменшим номером і додаємо її в кінець топологічного порядку.
  v = *minHeap.begin();
  minHeap.erase(minHeap.begin());
  Order.push_back(v);
Видаляємо з графа всі ребра (v, to), що виходять з вершини . Для кожного такого ребра зменшуємо вхідний степінь вершини . Якщо вхідний степінь вершини стає нульовим, додаємо її до множини, звідки вона потрапить до списку топологічного порядку.
 for (int to : g[v])
 {
   InDegree[to]--;
   if (InDegree[to] == 0) minHeap.insert(to);
 }
}
Якщо після виконання алгоритму в масив додано не всі вершин, то граф містить цикл, і топологічна сортування неможлива.
if (Order.size() < n)
  printf("-1");
else
Виводимо вершини графа в лексикографічно найменшому топологічному порядку.
  for (i = 0; i < Order.size(); i++)
    printf("%d ", Order[i]);
printf("\n");
Реалізація алгоритму — priority queue
#include <cstdio>
#include <queue>
#include <vector>
using namespace std;

vector<vector<int> > g;
vector<int> InDegree, Order;
priority_queue<long long, vector<long long>, greater<long long> > pq;
int i, n, m, a, b, v, to;

int main(void)
{
  scanf("%d %d", &n, &m);
  g.resize(n + 1);
  InDegree.resize(n + 1);

  for (i = 0; i < m; i++)
  {
    scanf("%d %d", &a, &b);
    g[a].push_back(b);
    InDegree[b]++;
  }

  for (i = 1; i < InDegree.size(); i++)
    if (InDegree[i] == 0) pq.push(i);

  while (!pq.empty())
  {
    v = pq.top(); pq.pop();
    Order.push_back(v);

    for (int to : g[v])
    {
      InDegree[to]--;
      if (InDegree[to] == 0) pq.push(to);
    }
  }

  if (Order.size() < n)
    printf("-1");
  else
    for (int x : Order)
      printf("%d ", x);
  printf("\n");
  return 0;
}
Java реалізація — priority queue
import java.util.*;
import java.io.*;

public class Main
{
  static ArrayList<ArrayList<Integer>> g;
  static ArrayList<Integer> top;
  static int InDegree[];
  static int n, m, flag = 0;

  public static void main(String[] args)
  {
    FastScanner con = new FastScanner(System.in);
    n = con.nextInt();
    m = con.nextInt();
    g = new ArrayList<ArrayList<Integer>>();
    InDegree = new int[n+1];

    for (int i = 0; i <= n; i++)
      g.add(new ArrayList<Integer>());

    for (int i = 0; i < m; i++)
    {
      int a = con.nextInt();
      int b = con.nextInt();
      g.get(a).add(b);
      InDegree[b]++;
    }

    PriorityQueue<Integer> pq = new PriorityQueue<Integer>();
    for(int i = 1; i <= n; i++)
      if (InDegree[i] == 0) pq.add(i);

    top = new ArrayList<Integer>();
    while (!pq.isEmpty())
    {
      int v = pq.poll();
      top.add(v);
      for (int to : g.get(v))
      {
        InDegree[to]--;
        if (InDegree[to] == 0) pq.add(to);
      }
    }

    if (top.size() < n)
      System.out.println("-1");
    else
    {
      for (int x : top) System.out.print(x + " ");
        System.out.println();
    }
  }
}

class FastScanner
{
  BufferedReader br;
  StringTokenizer st;

  public FastScanner(InputStream inputStream)
  {
    br = new BufferedReader(new InputStreamReader(inputStream));
    st = new StringTokenizer("");
  }

  public String next()
  {
    while (!st.hasMoreTokens())
    {
      try
      {
        st = new StringTokenizer(br.readLine());
      } catch (Exception e)
      {
        return null;
      }
    }
    return st.nextToken();
  }

  public int nextInt()
  {
    return Integer.parseInt(next());
  }
}Python реалізація — priority queue
Імпортуємо функції heappush і з модуля . — це вбудована бібліотека Python, яка надає реалізацію черги з пріоритетами на основі купи.
from heapq import heappush, heappopЧитаємо кількість вершин і ребер у графі.
n, m = map(int, input().split())Вхідний граф зберігаємо у вигляді списку суміжності . Вхідні степені вершин зберігаємо в масиві InDegree.
g = [[] for _ in range(n + 1)]
InDegree = [0] * (n + 1)
Читаємо вхідний граф. Обчислюємо вхідні степені для всіх вершин. Для кожного ребра збільшуємо значення вхідного степеня вершини .
for _ in range(m):
  a, b = map(int, input().split())
  g[a].append(b)
  InDegree[b] += 1
Усі вершини з нульовим вхідним степенем додаємо до списку .
minHeap = []
for i in range(1, len(InDegree)):
  if InDegree[i] == 0:
    heappush(minHeap, i)
Топологічно відсортовані вершини графа заносимо в масив .
Order = []Продовжуємо роботу алгоритму топологічної сортування, поки список не стане порожнім.
while minHeap:Витягуємо з вершину з найменшим номером і додаємо її в кінець топологічного порядку.
  v = heappop(minHeap)
  Order.append(v)
Видаляємо з графа всі ребра (v, to), що виходять з вершини . Для кожного такого ребра зменшуємо вхідний степінь вершини . Якщо вхідний степінь вершини стає нульовим, додаємо її до черги, звідки вона потрапить до списку топологічного порядку.
  for to in g[v]:
    InDegree[to] -= 1
    if InDegree[to] == 0:
      heappush(minHeap, to)
Якщо після виконання алгоритму в масив додано не всі вершин, то граф містить цикл, і топологічна сортування неможлива.
if len(Order) < n:
  print(-1)
Виводимо вершини графа в лексикографічно найменшому топологічному порядку.
else:
  print(*Order)