Conectividad fuerte#2403

El problema requiere encontrar el número de componentes fuertemente conexas de un grafo dirigido. Para ello, utilizamos el algoritmo de Kosaraju, que realiza dos búsquedas en profundidad:
realizar una búsqueda en profundidad en el grafo de entrada y registrar los vértices en el orden en que termina su procesamiento (en el momento de salir del vértice);
construir el grafo inverso invirtiendo la dirección de cada arista;
recorrer los vértices en el orden inverso de finalización de su procesamiento, e iniciar una búsqueda en profundidad en el grafo inverso desde cada vértice que aún no haya sido visitado. Cada uno de estos inicios recorre exactamente una componente fuertemente conexa.
El grafo inverso tiene las mismas componentes fuertemente conexas que el original: si existen caminos de a y de a , entonces al invertir las aristas estos caminos se preservan, solo cambia su dirección. El orden de procesamiento de los vértices en el segundo recorrido garantiza que la búsqueda en profundidad no abandone la componente actual: todas las componentes que podría alcanzar ya han sido visitadas para ese momento.
La respuesta es el número de inicios de búsqueda en profundidad en el segundo recorrido.
Ejemplo
Los grafos dados en los ejemplos se muestran a continuación. Las componentes fuertemente conexas están resaltadas en color.
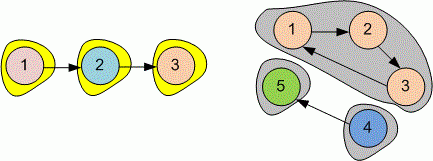
El primer grafo no contiene ciclos: es imposible regresar a ningún vértice. Por lo tanto, cada vértice forma una componente fuertemente conexa separada: , , .
En el segundo grafo, los vértices , y se encuentran en el ciclo 1 \to 2 \to 3 \to 1 y forman una componente \{1, 2, 3\}. El vértice no puede ser alcanzado desde el vértice , por lo que los vértices y forman componentes separadas y . Por lo tanto, cada uno de los grafos contiene componentes fuertemente conexas.
Simulemos el algoritmo en el segundo grafo. La primera búsqueda en profundidad desde el vértice sigue el camino 1 \to 2 \to 3, y luego desde el vértice el camino 4 \to 5. El orden en que termina el procesamiento de los vértices es top = (3, 2, 1, 5, 4). Después de invertir, obtenemos (4, 5, 1, 2, 3).
El grafo inverso contiene las aristas 2 \to 1, 3 \to 2, 1 \to 3 y 5 \to 4. Realicemos el segundo recorrido en el orden (4, 5, 1, 2, 3):
: el vértice no tiene aristas salientes en el grafo inverso, componente ;
: la arista 5 \to 4 lleva a un vértice ya visitado, componente ;
: recorre el camino 1 \to 3 \to 2, componente \{1, 3, 2\}.
Los vértices y ya han sido visitados, por lo que no hay nuevos inicios. Obtenemos c = 3 componentes.
Observe que en el grafo inverso el vértice , que pertenece a otra componente, es alcanzable desde el vértice . Sin embargo, el vértice se procesa antes que el vértice , por lo que para cuando se llama a ya ha sido visitado y no entra en la componente del vértice .
Implementación del algoritmo
Almacenamos el grafo de entrada como una lista de adyacencia , y el grafo inverso como una lista de adyacencia . El arreglo marca los vértices visitados. El arreglo almacena los vértices en el orden en que termina su procesamiento durante la primera búsqueda en profundidad.
vector<vector<int> > g, gr;
vector<int> used, top;
La función dfs1 realiza una búsqueda en profundidad en el grafo de entrada. El vértice se agrega al final del arreglo después de que todos los vértices alcanzables desde él hayan sido procesados, es decir, en el momento de salir de él.
void dfs1(int v)
{
  used[v] = 1;
  for (int to : g[v])
    if (!used[to]) dfs1(to);
  top.push_back(v);
}La función dfs2 realiza una búsqueda en profundidad en el grafo inverso. Todos los vértices visitados durante una llamada de desde el programa principal forman una componente fuertemente conexa.
void dfs2(int v)
{
  used[v] = 1;
  for (int to : gr[v])
    if (!used[to]) dfs2(to);
}
La parte principal del programa. Leemos el grafo de entrada. Agregamos cada arista a \to b al grafo , y la arista opuesta b \to a al grafo inverso .
scanf("%d %d", &n, &m);
g.resize(n + 1);
gr.resize(n + 1);
for(i = 1; i <= m; i++)
{
  scanf("%d %d", &a, &b);
  g[a].push_back(b);
  gr[b].push_back(a);
}Iniciamos una búsqueda en profundidad en el grafo de entrada desde cada vértice que aún no haya sido visitado. Después de esto, el arreglo contiene todos los vértices del grafo en el orden en que terminó su procesamiento.
used.resize(n+1);
for(i = 1; i <= n; i++)
  if (!used[i]) dfs1(i);
Antes del segundo recorrido, reiniciamos el arreglo . Los vértices del grafo inverso deben considerarse en el orden inverso de finalización de su procesamiento, es decir, el arreglo debe recorrerse de atrás hacia adelante. Por conveniencia, invertimos el arreglo .
used.assign(n + 1, 0);
reverse(top.begin(), top.end());
La variable cuenta el número de componentes fuertemente conexas.
c = 0;Recorremos el arreglo de izquierda a derecha. Desde cada vértice que aún no haya sido visitado, iniciamos la búsqueda en profundidad dfs2 en el grafo inverso. Esta recorre exactamente una nueva componente fuertemente conexa, por lo que aumentamos en .
for (int v : top)
  if (!used[v])
  {
    dfs2(v);
    c++;
  }
Imprimimos el número de componentes fuertemente conexas del grafo.
printf("%d\n",c);Implementación en Java
import java.util.*;

public class Main
{
  static ArrayList<Integer>[] g, gr;
  static boolean used[];
  static Vector<Integer> top = new Vector<Integer>();

  static void dfs1(int v)
  {
    used[v] = true;
    for(int i = 0; i < g[v].size(); i++)
    {
      int to = g[v].get(i);
      if (!used[to]) dfs1(to);
    }
    top.add(v);
  }

  static void dfs2(int v)
  {
    used[v] = true;
    for(int i = 0; i < gr[v].size(); i++)
    {
      int to = gr[v].get(i);
      if (!used[to]) dfs2(to);
    }
  }

  @SuppressWarnings("unchecked")
  public static void main(String[] args)
  {
    Scanner con = new Scanner(System.in);
    int n = con.nextInt();
    int m = con.nextInt();

    g = new ArrayList[n+1];
    for(int i = 0; i <= n; i++)
      g[i] = new ArrayList<Integer>();
    gr = new ArrayList[n+1];
    for(int i = 0; i <= n; i++)
      gr[i] = new ArrayList<Integer>();

    for (int i = 0; i < m; i++)
    {
      int a = con.nextInt();
      int b = con.nextInt();
      g[a].add(b);
      gr[b].add(a);
    }
    used = new boolean[n+1];
    for(int i = 1; i <= n; i++)
      if (!used[i]) dfs1(i);

    used = new boolean[n+1];
    int c = 0;
    for(int i = 1; i <= n; i++)
    {
      int v = top.get(n-i);
      if (!used[v])
      {
        dfs2(v);
        c++;
      }
    }

    System.out.println(c);
    con.close();
  }
}Implementación en Python
La función dfs1 realiza una búsqueda en profundidad en el grafo de entrada. El vértice se agrega al final de la lista después de que todos los vértices alcanzables desde él hayan sido procesados, es decir, en el momento de salir de él.
def dfs1(v):
  global g, used, top
  used[v] = True
  for to in g[v]:
    if not used[to]: dfs1(to)
  top.append(v)
La función dfs2 realiza una búsqueda en profundidad en el grafo inverso. Todos los vértices visitados durante una llamada de desde el programa principal forman una componente fuertemente conexa.
def dfs2(v):
  global gr, used
  used[v] = True
  for to in gr[v]:
    if not used[to]: dfs2(to)
La parte principal del programa. Leemos el grafo de entrada. Agregamos cada arista a \to b al grafo , y la arista opuesta b \to a al grafo inverso .
n, m = map(int, input().split())
g = [[] for _ in range(n + 1)]
gr = [[] for _ in range(n + 1)]
for _ in range(m):
  a, b = map(int, input().split())
  g[a].append(b)
gr[b].append(a)Iniciamos una búsqueda en profundidad en el grafo de entrada desde cada vértice que aún no haya sido visitado. Después de esto, la lista contiene todos los vértices del grafo en el orden en que terminó su procesamiento.
used = [False] * (n + 1)
top = []
for i in range(1, n + 1):
  if not used[i]: dfs1(i)
Antes del segundo recorrido, reiniciamos la lista . Los vértices del grafo inverso deben considerarse en el orden inverso de finalización de su procesamiento, así que invertimos la lista .
used = [False] * (n + 1)
top.reverse()
La variable cuenta el número de componentes fuertemente conexas.
c = 0Recorremos la lista de izquierda a derecha. Desde cada vértice que aún no haya sido visitado, iniciamos la búsqueda en profundidad dfs2 en el grafo inverso. Esta recorre exactamente una nueva componente fuertemente conexa, por lo que aumentamos en .
for v in top:
  if not used[v]:
    dfs2(v)
    c += 1
Imprimimos el número de componentes fuertemente conexas del grafo.
print(c)