Граф#7618

Лексикографічно найменше топологічне сортування будується алгоритмом Кана з чергою з пріоритетом: на кожному кроці серед усіх доступних вершин (вершин, у які не входить жодне ребро з ще не виписаних вершин) обирається вершина з найменшим номером.
Додане ребро u \to v робить вершину недоступною доти, доки не буде виписано вершину . Отже, додаючи ребра, ми можемо "ховати" малі вершини й тим самим змушувати алгоритм обирати вершини з більшими номерами. Кожна схована вершина коштує одне ребро із запасу .
Жадібна ідея. Будуватимемо відповідь позиція за позицією. Лексикографічне порівняння визначається першою позицією, на якій послідовності відрізняються, тому на кожній позиції треба поставити вершину з найбільшим можливим номером — жодні виграші на наступних позиціях не компенсують програш на поточній.
Розділимо вершини, які можна виписати на поточному кроці, на дві множини:
— доступні вершини: усі ребра, що входять у них, уже "зняті". Якщо нічого не робити, алгоритм Кана обере найменшу вершину з ;
— відкладені вершини. Це вершини, які були доступними, але ми вирішили їх сховати. Для кожної такої вершини ми зобов'язуємося додати ребро, що входить у неї. Початок цього ребра ми оберемо пізніше — ним стане вершина, виписана безпосередньо перед відкладеною.
Множину зберігаємо в черзі з пріоритетом з найменшим елементом на вершині (min-купа), а множину — у черзі з пріоритетом з найбільшим елементом на вершині (max-купа).
Коли вигідно відкладати вершину. Нехай — найменша вершина в . Якщо її не чіпати, на поточну позицію стане . Відкладати (витрачати ребро) має сенс у двох випадках:
в є щонайменше дві вершини. Тоді після того, як буде відкладено, на поточну позицію стане наступна за зростанням вершина з , яка більша за ;
в є лише вершина , але в є відкладена вершина y > x. Тоді після відкладання множина стане порожньою, і на поточну позицію стане найбільша відкладена вершина — число, більше за .
В усіх інших випадках відкладання не збільшує число на поточній позиції, і витрачати ребро не потрібно. Відкладаємо вершини по одній, починаючи з найменшої, доки це вигідно і доки не вичерпано запас .
Яку вершину виписати. Після відкладання:
якщо не порожня, виписуємо найменшу вершину з — цього вимагає правило лексикографічно найменшого сортування;
якщо порожня, виписуємо найбільшу відкладену вершину з і додаємо ребро з останньої виписаної вершини у . Саме це ребро "ховало" вершину : досі вона була недоступною, а тепер, коли виписано її нового попередника, вона стає єдиною доступною вершиною. Решта відкладених вершин лишаються схованими — їхні ребра буде додано пізніше.
Потім, як зазвичай в алгоритмі Кана, зменшуємо вхідні степені сусідів виписаної вершини; вершини, вхідний степінь яких стає нульовим, додаються до .
Чому відповідь коректна. Кожну відкладену вершину рано чи пізно буде виписано з , і саме в цей момент додається рівно одне ребро. Тому кількість доданих ребер дорівнює кількості відкладань і не перевищує . Усі додані ребра йдуть з вершини, виписаної раніше, у вершину, виписану пізніше, тому знайдений порядок є топологічним сортуванням нового графа, і циклів не виникає.
Складність. Кожна вершина потрапляє до не більше одного разу і до не більше одного разу, а кожне ребро графа переглядається один раз. Загальна складність становить O((n + m) \log n).
Алгоритм розв'язання задачі
Використовуємо алгоритм Кана і дві черги з пріоритетом:
— min-купа, що зберігає доступні вершини; на її вершині — вершина з найменшим номером.
— max-купа, що зберігає відкладені вершини; на її вершині — вершина з найбільшим номером.
Оголосимо такі масиви:
indeg[v] — кількість вхідних ребер вершини , які ще не оброблено;
— результуюче топологічне впорядкування;
— список доданих ребер.
Крок 1. Ініціалізація
Обчислити вхідний степінь кожної вершини.
Додати до усі вершини з нульовим вхідним степенем.
Ініціалізувати і список порожніми.
Крок 2. Побудова відповіді
Доки не оброблено всі вершин:
1. Відкласти вершину, якщо це вигідно.
Доки кількість доданих ребер менша за , купа не порожня і виконується хоча б одна з умов:
містить щонайменше дві вершини;
містить одну вершину , а містить вершину таку, що y > x.
Вилучити найменшу вершину з і додати її до . Цю вершину буде оброблено пізніше.
2. Обрати наступну вершину.
Якщо не порожня, вилучити з неї найменшу вершину .
Інакше вилучити найбільшу вершину з . Якщо не порожній, додати ребро з останньої вершини в у .
Додати у кінець .
3. Оновити граф.
Для кожного вихідного ребра v \to u:
Зменшити indeg[u] на одиницю.
Якщо indeg[u] став рівним нулю, додати до .
Повторювати ці кроки, доки всі вершини не потраплять до .
Крок 3. Виведення
Вивести послідовність .
Вивести кількість доданих ребер.
Вивести самі додані ребра.
Приклад
Розглянемо приклад з умови: n = 5, k = 2, ребра 1 \to 4, 4 \to 2, 1 \to 3. Початкові вхідні степені: вершини і мають вхідний степінь , вершини — вхідний степінь . Початкові множини: A = \{1, 5\}, B = \{\,\}.
Крок | Відкладаємо | Беремо | Ребро | Порядок | |||
(в дві вершини) | з | — | |||||
— | з | 5 \to 1 | |||||
(в дві вершини: і ) | з | — | |||||
— (k = 0) | з | — | 5, 1, 4, 2 | ||||
— | з | 2 \to 3 | 5, 1, 4, 2, 3 |
Розглянемо кроки докладніше.
Крок 1. A = \{1, 5\} містить дві вершини, тому відкладаємо найменшу — . Тепер A = \{5\} містить одну вершину, а в немає вершин, більших за , тому припиняємо відкладання. Виписуємо .
Крок 2. порожня. Виписуємо найбільшу відкладену вершину і додаємо ребро 5 \to 1. Знімаємо ребра 1 \to 4 і 1 \to 3: вершини і стають доступними, A = \{3, 4\}.
Крок 3. містить дві вершини — відкладаємо , і запас ребер вичерпано (k = 0). Виписуємо , після чого ребро 4 \to 2 знімається і A = \{2\}.
Крок 4. Відкладати більше неможливо. Виписуємо .
Крок 5. порожня. Виписуємо відкладену вершину і додаємо ребро 2 \to 3.
Отримуємо порядок 5, 1, 4, 2, 3 і додані ребра 5 \to 1 та 2 \to 3. Початковий граф (ліворуч) і граф з доданими ребрами (праворуч, додані ребра позначено червоним):
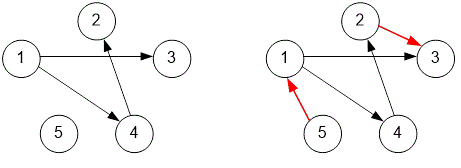
Без доданих ребер лексикографічно найменше сортування таке: 1, 3, 4, 2, 5: вершина ні з чим не пов'язана, але через великий номер обирається останньою. Після додавання двох ребер вершина стає першою, і порядок 5, 1, 4, 2, 3 лексикографічно більший.
Розглянемо ще один приклад, у якому на початку доступні чотири вершини. Нехай n = 8, m = 6, k = 4, а ребра графа такі: 6 \to 3, 4 \to 8, 3 \to 5, 1 \to 7, 2 \to 7, 5 \to 7.
У вершини 1, 2, 4, 6 не входить жодне ребро, тому на початку A = \{1, 2, 4, 6\}, B = \{\,\}. Без доданих ребер лексикографічно найменше сортування таке: 1, 2, 4, 6, 3, 5, 7, 8.
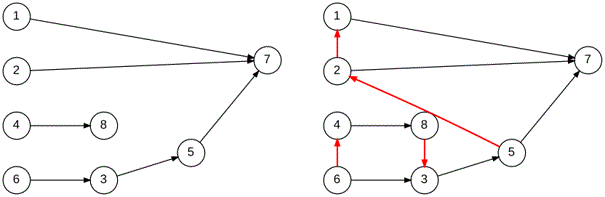
Початковий граф (ліворуч) і граф після додавання ребер (праворуч, додані ребра позначено червоним)
Крок | до | до | Відкладаємо | Беремо | Ребро | |
\{1, 2, 4, 6\} | з | — | ||||
\{4, 2, 1\} | 3~(4 > 3) | з | 6 \to 4 | |||
\{3, 2, 1\} | — | з | — | |||
\{3, 2, 1\} | — | з | 8 \to 3 | |||
— | з | — | ||||
— | з | 5 \to 2 | ||||
— | з | 2 \to 1 | ||||
— | з | — |
Розглянемо кроки докладніше.
Крок 1. A = \{1, 2, 4, 6\}, k = 4. Відкладаємо вершину , оскільки містить чотири вершини, потім (в три вершини), потім (в дві вершини). Запас зменшується до k = 1. Тепер A = \{6\} містить одну вершину, а найбільша відкладена вершина менша за — подальше відкладання невигідне. Виписуємо . Ребро 6 \to 3 знімається, і A = \{3\}.
Крок 2. A = \{3\}, B = \{4, 2, 1\}, k = 1. містить одну вершину, але містить вершину 4 > 3, тому відкладаємо і ; запас вичерпано, k = 0. порожня — виписуємо найбільшу відкладену вершину і додаємо ребро 6 \to 4. Ребро 4 \to 8 знімається, і A = \{8\}.
Крок 3. Відкладати більше неможливо. Виписуємо , після чого порожня.
Крок 4. Виписуємо найбільшу відкладену вершину і додаємо ребро 8 \to 3. Ребро 3 \to 5 знімається, і A = \{5\}.
Крок 5. Виписуємо . Ребро 5 \to 7 знімається, але у вершину ще входять ребра з і , тому порожня.
Крок 6. Виписуємо відкладену вершину і додаємо ребро 5 \to 2. Ребро 2 \to 7 знімається.
Крок 7. Виписуємо відкладену вершину і додаємо ребро 2 \to 1. Ребро 1 \to 7 знімається, і A = \{7\}.
Крок 8. Виписуємо .
Відповідь:
6 4 8 3 5 2 1 7
4
6 4
8 3
5 2
2 1
Цей приклад добре ілюструє всі випадки роботи алгоритму. На кроці відкладаються одразу три вершини — доки містить щонайменше дві вершини. На кроці спрацьовує друга умова: містить лише вершину , але містить більшу вершину , тому теж відкладається. Відкладені вершини залишають у порядку спадання (4, 3, 2, 1), і кожна з них отримує рівно одне ребро з вершини, виписаної перед нею. Тому ребер додано рівно стільки, скільки було відкладань, — чотири.
Реалізація алгоритму
Читаємо вхідні дані. Будуємо граф. Списки суміжності зберігаємо в , вхідні степені — в .
scanf("%d %d %d", &n, &m, &k);
vector<vector<int>> g(n + 1);
vector<int> indeg(n + 1, 0);
for (int i = 0; i < m; i++)
{
  scanf("%d %d", &u, &v);
  g[u].push_back(v);
  indeg[v]++;
}Оголосимо дві черги з пріоритетом: — доступні вершини, з найменшим елементом на вершині (min-купа); — відкладені вершини, з найбільшим елементом на вершині (max-купа).
priority_queue<int, vector<int>, greater<int>> A; // доступні, min-купа
priority_queue<int> B;                            // відкладені, max-купа
Спочатку доступні всі вершини з нульовим вхідним степенем.
for (int v = 1; v <= n; v++)
  if (indeg[v] == 0) A.push(v);
У масиві накопичуємо відповідь — шукане топологічне сортування, а в масиві зберігаємо додані ребра.
vector<int> order;
order.reserve(n);
vector<pair<int, int>> added;
Кожна ітерація циклу додає до відповіді одну вершину, доки не буде виписано всі вершин.
while ((int)order.size() < n)
{
Відкладаємо вершини. Доки в запасі залишаються ребра і множина не порожня, розглядаємо найменшу доступну вершину . Її вигідно відкласти, якщо містить ще хоча б одну вершину або якщо містить відкладену вершину з більшим номером. Відкладена вершина переноситься з до , а запас зменшується на . Інакше відкладання припиняється.
  // відкладаємо вершини, доки це вигідно і є запас ребер
  while (k > 0 && !A.empty())
  {
    int x = A.top();
    if (A.size() >= 2 || (!B.empty() && B.top() > x))
    {
      A.pop();
      B.push(x);
      k--;
    }
    else break;
}Обираємо вершину , яку буде виписано на поточну позицію. Якщо не порожня, це найменша доступна вершина. Інакше беремо найбільшу відкладену вершину і додаємо ребро з останньої виписаної вершини order.back() у .
  int v;
  if (!A.empty())
  {
    v = A.top();
    A.pop();
  }
  else
  {
    v = B.top();
    B.pop();
    added.push_back(make_pair(order.back(), v));
}Дописуємо до відповіді і, як в алгоритмі Кана, зменшуємо вхідні степені її сусідів. Вершини, вхідний степінь яких став нульовим, стають доступними.
  order.push_back(v);
  for (int to : g[v])
    if (--indeg[to] == 0) A.push(to);
}
Виводимо знайдене топологічне сортування, кількість доданих ребер і самі ребра.
for (int i = 0; i < n; i++)
  printf("%d ", order[i]);
printf("\n%d\n", added.size());
for (auto &e : added)
  printf("%d %d\n", e.first, e.second);