Самотній острів#9044

За умовою задачі, якщо ви залишили острів, повернутися на нього вже неможливо. Отже, граф, вершинами якого є острови, а ребрами — мости, є орієнтованим ациклічним графом. Застрягнути можна лише на острові , з якого не виходить жоден міст, тобто у тупиковій вершині з нульовим вихідним степенем: OutDegree[v] = 0.
Нехай prob[v] позначає ймовірність того, що під час прогулянки ми потрапимо у вершину . Для стартової вершини prob[r] = 1; для всіх інших вершин спочатку prob[v] = 0. Оскільки граф не містить циклів, кожну вершину можна відвідати не більше одного разу.
Припустимо, з вершини виходить OutDegree[u] ребер. Перебуваючи у , ми обираємо одне з них рівноймовірно, тому переходимо по кожному ребру u \to v з ймовірністю prob[u] / OutDegree[u]. У вершину можна потрапити лише з її безпосередніх попередників. Тому prob[v] дорівнює сумі внесків усіх ребер u \to v, що входять у :
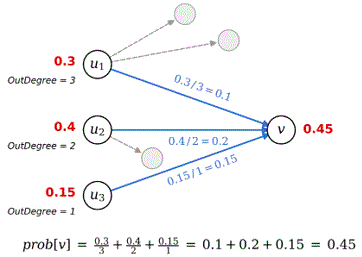
Значення prob[v] можна обчислити лише тоді, коли ймовірності всіх його попередників уже остаточні. Саме такий порядок обробки задає топологічне сортування: кожна вершина з'являється після усіх вершин, з яких у неї ведуть ребра. Тому ми будуємо топологічний порядок за допомогою алгоритму Кана і одночасно "проштовхуємо" ймовірності вздовж ребер.
Алгоритм виглядає так:
для кожної вершини обчислити її вхідний степінь InDegree[v] та вихідний степінь OutDegree[v];
додати до черги всі вершини з нульовим вхідним степенем і встановити prob[r] = 1;
поки черга не порожня, вилучити з неї вершину . На цей момент усі її попередники вже оброблені, тож значення prob[v] остаточне. Для кожного ребра v \to to додати prob[v] / OutDegree[v] до prob[to] і зменшити InDegree[to] на . Якщо вхідний степінь вершини стає нульовим, додати її до черги.
Спочатку черга містить усі вершини з нульовим вхідним степенем, а не лише стартову. Вершини, недосяжні з , також обробляються, але їхня ймовірність залишається нульовою і не впливає на відповідь.
Знаходження відповіді. Серед тупикових вершин знайдіть максимальну ймовірність . Потім виведіть, у порядку зростання, індекси всіх тупикових вершин , для яких |prob[v] - mx| \le 10^{-9}. Порівняння з допуском необхідне, оскільки ймовірності обчислюються у числах з плаваючою комою з похибками округлення.
Складність. Кожна вершина додається до черги та вилучається з неї рівно один раз, а кожне ребро розглядається один раз. Час роботи алгоритму становить O(n + m).
Приклад
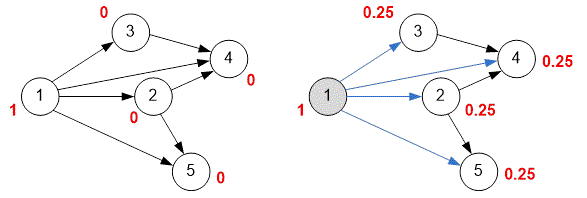
Змоделюємо роботу алгоритму на графі з прикладу. Поруч із кожною вершиною показано ймовірність prob[v] потрапляння до неї. Оброблені вершини зафарбовано сірим, ребра, вздовж яких ймовірність розподіляється на поточному кроці, виділено синім, а вже розглянуті ребра зображено пунктиром.
Спочатку (ліва фігура) prob[1] = 1, а ймовірності всіх інших вершин дорівнюють . Вершина — єдина вершина з нульовим вхідним степенем, тому вона першою вилучається з черги.
З вершини виходить чотири ребра, тому ймовірність prob[1] = 1 рівномірно розподіляється між вершинами та : кожна з них отримує 1 / 4 = 0.25 (права фігура). Після видалення ребер, що виходять з вершини , вхідні степені вершин та стають нульовими, і їх додають до черги.
Далі обробляється вершина . З неї виходить два ребра, тому до та додається prob[2] / 2 = 0.25 / 2 = 0.125. Отримуємо prob[4] = prob[5] = 0.375 (нижня ліва фігура). Вхідний степінь вершини стає нульовим, і її додають до черги.
Наступною обробляється вершина . З неї виходить одне ребро 3 \to 4, тому збільшується на prob[3] / 1 = 0.25 і стає (нижня права фігура). Тепер вершину також додають до черги.
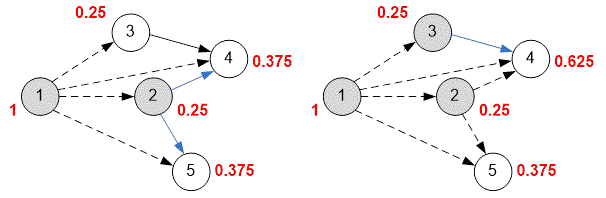
Вершини та не мають вихідних ребер, тому їх обробка не змінює жодних ймовірностей. Отриманий топологічний порядок: 1, 2, 3, 5, 4.
Тупикові вершини — це та , з ймовірностями та відповідно. Їхня сума дорівнює : ми напевно десь застрягнемо. Максимальна ймовірність досягається у єдиній вершині , яка і є відповіддю.
Реалізація алгоритму
Оголосимо константу — допуск для порівняння чисел з плаваючою комою.
#define EPS 1e-9Зберігатимемо вхідний граф у вигляді списку суміжності . Вхідні та вихідні степені вершин зберігатимемо у масивах InDegree та OutDegree. Черга використовується в алгоритмі Кана. У prob[v] обчислюємо ймовірність потрапляння у вершину .
vector<vector<int>> g;
vector<int> InDegree, OutDegree;
deque<int> q;
vector<double> prob;
Зчитаємо кількість островів , кількість мостів та індекс стартового острова . Ініціалізуємо список суміжності та масиви степенів.
scanf("%d %d %d", &n, &m, &r);
g.assign(n + 1, vector<int>());
InDegree.assign(n + 1, 0);
OutDegree.assign(n + 1, 0);
Зчитаємо мости та побудуємо граф. Для кожного ребра a \to b збільшимо вихідний степінь вершини та вхідний степінь вершини .
for (i = 0; i < m; i++)
{
  scanf("%d %d", &a, &b);
  g[a].push_back(b);
  OutDegree[a]++;
  InDegree[b]++;
}Додамо до черги всі вершини з нульовим вхідним степенем — топологічне сортування починається саме з них.
for (i = 1; i < InDegree.size(); i++)
  if (InDegree[i] == 0) q.push_back(i);
Ймовірність перебування у стартовій вершині дорівнює . Для всіх інших вершин початкова ймовірність дорівнює : функція заповнює масив нулями.
prob.resize(n + 1);
prob[r] = 1;
Запустимо алгоритм Кана. Вершини вилучаються з черги у топологічному порядку.
while (!q.empty())
{
Вилучимо вершину з черги. На цей момент усі її попередники вже оброблені, тож значення prob[v] остаточне. Переберемо ребра (v, to). З вершини виходить OutDegree[v] ребер, і кожне з них обирається з однаковою ймовірністю. Тому ми переходимо по ребру v \to to з ймовірністю prob[v] / OutDegree[v]. Додамо це значення до prob[to].
  v = q.front(); q.pop_front();
  for (int to : g[v])
  {
    prob[to] += prob[v] / OutDegree[v];
Видалимо ребро (v, to) з графа — зменшимо вхідний степінь вершини .
InDegree[to]--;Якщо вхідний степінь вершини стає нульовим, усі її попередники оброблені, і значення prob[to] остаточне. Додамо до черги.
    if (InDegree[to] == 0) q.push_back(to);
  }
}
Знайдемо максимальну ймовірність серед тупикових вершин — островів без вихідних мостів (OutDegree[i] = 0).
mx = 0;
for (i = 1; i <= n; i++)
  if (OutDegree[i] == 0 && prob[i] > mx) mx = max(mx, prob[i]);
Виведемо, у порядку зростання, індекси всіх тупикових вершин, ймовірність яких відрізняється від не більше ніж на . Таких вершин може бути декілька.
for (i = 1; i <= n; i++)
  if (OutDegree[i] == 0 && fabs(prob[i] - mx) <= EPS)
    printf("%d ", i);