Be Geeks!#9760

Il numero di coppie è pari a n \cdot (n + 1) / 2 e per n = 2 \cdot 10^5 è circa 2 \cdot 10^{10}, quindi enumerare tutti i segmenti è impossibile. Calcoliamo la somma con il metodo "divide et impera", suddividendo l'array nella posizione dell'elemento massimo.
Suddivisione nel massimo. Supponiamo di dover trovare la somma di P(i, j) su tutti i segmenti contenuti nel segmento . Troviamo la posizione dell'elemento massimo su . Ogni segmento [i; j] \subseteq [b; e] appartiene esattamente a uno dei tre tipi:
contiene la posizione , cioè b \le i \le m \le j \le e;
è interamente contenuto in [b; m - 1];
è interamente contenuto in [m + 1; e].
I segmenti del secondo e del terzo tipo vengono elaborati ricorsivamente. Per i segmenti del primo tipo il massimo è pari ad a_m, quindi M(i, j) = a_m, e il loro contributo totale è pari a
Resta da calcolare rapidamente la somma dei MCD su tutti i segmenti che contengono la posizione .
Scomposizione del MCD. Un segmento che contiene è formato dalla parte sinistra e dalla parte destra . Pertanto
Quindi il MCD di un segmento è determinato da una coppia di valori: il MCD della parte sinistra e il MCD della parte destra.
Gruppi di estremi. Al crescere di il valore G(m, j) non aumenta. Inoltre, ogni volta che cambia, il nuovo valore è un divisore proprio del precedente ed è quindi almeno due volte più piccolo. Di conseguenza G(m, j) assume al più \lfloor \log_2 C \rfloor + 1 valori distinti, dove è il valore massimo di un elemento. Per C \le 10^9 si tratta di al più \lfloor \log_2 C \rfloor + 1 = 30 valori.
Le posizioni con lo stesso valore di G(m, j) formano un blocco contiguo. Chiamiamo un tale blocco di posizioni gruppo. Ogni gruppo è descritto da una coppia (g, \mathit{cnt}), dove è il valore del MCD e è il numero di posizioni nel gruppo. Analogamente, gli estremi sinistri vengono suddivisi in gruppi in base al valore di .
La fine di un gruppo si trova con la ricerca binaria. Se un gruppo inizia nella posizione e g = G(m, j), allora l'uguaglianza G(m, t) = g vale per tutti i da fino alla fine del gruppo e non vale per tutti i successivi.
Somma sulle coppie di gruppi. Sia (g_L, \mathit{cnt}_L) il gruppo sinistro e (g_R, \mathit{cnt}_R) il gruppo destro. Allora tutti i \mathit{cnt}_L \cdot \mathit{cnt}_R segmenti il cui estremo sinistro appartiene al gruppo sinistro e il cui estremo destro appartiene al gruppo destro hanno lo stesso MCD \gcd(g_L, g_R). Pertanto
dove la seconda somma è presa su tutte le coppie formate da un gruppo sinistro e un gruppo destro. Il numero di tali coppie non supera 30 \cdot 30.
Query su intervallo. Per trovare la posizione del massimo e per calcolare il MCD su un segmento usiamo due sparse table. Entrambe le operazioni sono idempotenti: \max(x, x) = x e \gcd(x, x) = x. Pertanto una query su intervallo si risolve con due blocchi sovrapposti di lunghezza 2^k.
Il valore di è molto grande, quindi tutti i calcoli vengono eseguiti modulo 10^9 + 7.
Complessità. Ogni chiamata ricorsiva esclude dalla considerazione una posizione , quindi le chiamate sono al più . In ogni chiamata ci sono al più O(\log C) gruppi per ciascun lato. La fine di un gruppo si trova con una ricerca binaria che esegue O(\log n) query del MCD, e ogni query richiede O(\log C). L'iterazione sulle coppie di gruppi richiede O(\log^2 C) calcoli del MCD. La costruzione delle sparse table richiede O(n \log n \cdot \log C). La complessità complessiva è O(n \log^2 C \cdot (\log n + \log C)). In pratica i gruppi sono molto meno di e l'algoritmo è veloce.
Esempio
Consideriamo il secondo esempio: A = (2, 4, 6, 12, 3). Le posizioni sono numerate a partire da uno.
La prima chiamata elabora l'intero array . L'elemento massimo è a_4 = 12, quindi m = 4. La figura mostra i gruppi degli estremi sinistri e destri.
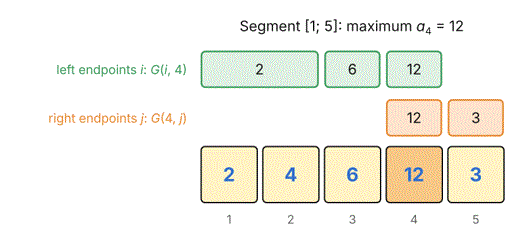
Estremi sinistri: G(4, 4) = 12, G(3, 4) = \gcd(6, 12) = 6, G(2, 4) = G(1, 4) = 2. Otteniamo i gruppi , e .
Estremi destri: G(4, 4) = 12, G(4, 5) = \gcd(12, 3) = 3. Otteniamo i gruppi e .
Esaminiamo tutte le coppie di gruppi:
gruppo sinistro | gruppo destro | MCD | segmenti | contributo |
(12, 1) | (12, 1) | 12 | 1 | 12 |
(12, 1) | (3, 1) | 3 | 1 | 3 |
(6, 1) | (12, 1) | 6 | 1 | 6 |
(6, 1) | (3, 1) | 3 | 1 | 3 |
(2, 2) | (12, 1) | 2 | 2 | 4 |
(2, 2) | (3, 1) | 1 | 2 | 2 |
La somma dei MCD sui segmenti che contengono la posizione è 12 + 3 + 6 + 3 + 4 + 2 = 30, e il contributo di questi segmenti è 12 \cdot 30 = 360. Ad esempio, l'ultima riga della tabella corrisponde ai segmenti e : per ciascuno di essi il MCD è 1 e il massimo è 12.
Successivamente vengono elaborati ricorsivamente i segmenti e . Tutte le chiamate sono riportate nella tabella:
segmento | \boldsymbol{a_m} | gruppi sinistri | gruppi destri | somma MCD | contributo | |
\boldsymbol{[1; 5]} | 4 | 12 | (12, 1), (6, 1), (2, 2) | (12, 1), (3, 1) | 30 | 360 |
\boldsymbol{[1; 3]} | 3 | 6 | (6, 1), (2, 2) | (6, 1) | 10 | 60 |
\boldsymbol{[1; 2]} | 2 | 4 | (4, 1), (2, 1) | (4, 1) | 6 | 24 |
\boldsymbol{[1; 1]} | 1 | 2 | (2, 1) | (2, 1) | 2 | 4 |
\boldsymbol{[5; 5]} | 5 | 3 | (3, 1) | (3, 1) | 3 | 9 |
La risposta è 360 + 60 + 24 + 4 + 9 = 457.
Implementazione dell'algoritmo
Dichiariamo le costanti:
\mathit{MOD} = 10^9 + 7 — il modulo,
\mathit{LOG} = 18 — l'esponente massimo nelle sparse table (2^{18} > 2 \cdot 10^5).
Dichiariamo il tipo ll.
#define MOD 1000000007LL
#define LOG 18 // 2^18 = 262144 > 2*10^5
typedef long long ll;
La sequenza è memorizzata nell'array ; gli elementi sono indicizzati a partire da zero. Il valore è pari a \lfloor \log_2 \mathit{len} \rfloor. La sparse table \mathit{spMax}[i][k] memorizza l'indice dell'elemento massimo, mentre \mathit{spGcd}[i][k] memorizza il MCD degli elementi sul segmento [i; i + 2^k - 1].
vector<int> a;
vector<int> lg2;          // lg2[len] = floor(log2(len))
// spMax[i][k] — indice del massimo su [i, i + 2^k)
vector<vector<int>> spMax;
// spGcd[i][k] — MCD su [i, i + 2^k)
vector<vector<int>> spGcd;
La funzione gcd calcola il MCD di due numeri con l'algoritmo di Euclide.
int gcd(int x, int y)
{
  while (y) { int t = x % y; x = y; y = t; }
  return x;
}
La funzione better, dati due indici e , restituisce quello il cui elemento dell'array è maggiore. Se gli elementi sono uguali, restituisce .
int better(int i, int j)
{
  return a[i] >= a[j] ? i : j;
}
La funzione build riempie l'array e costruisce entrambe le sparse table in O(n \log n \cdot \log C), C \le 10^9.
void build()
{
  lg2.assign(n + 1, 0);
  for (int len = 2; len <= n; len++) lg2[len] = lg2[len / 2] + 1;
  spMax.assign(n, vector<int>(LOG + 1));
  spGcd.assign(n, vector<int>(LOG + 1));
  for (int i = 0; i < n; i++)
  {
    spMax[i][0] = i;
    spGcd[i][0] = a[i];
  }
  for (int k = 1; (1 << k) <= n; k++)
    for (int i = 0; i + (1 << k) <= n; i++)
    {
      int h = 1 << (k - 1);    // metà della lunghezza del blocco
      spMax[i][k] = better(spMax[i][k - 1], spMax[i + h][k - 1]);
      spGcd[i][k] = gcd(spGcd[i][k - 1], spGcd[i + h][k - 1]);
    }
}La funzione qMax restituisce l'indice dell'elemento massimo sul segmento [l; r].
int qMax(int l, int r)
{
  int k = lg2[r - l + 1];
  return better(spMax[l][k], spMax[r - (1 << k) + 1][k]);
}
La funzione qGcd restituisce il MCD degli elementi sul segmento [l; r]. I blocchi di lunghezza 2^k possono sovrapporsi, ma ciò non influisce sul risultato, poiché \gcd(x, x) = x.
int qGcd(int l, int r)
{
  int k = lg2[r - l + 1];
  return gcd(spGcd[l][k], spGcd[r - (1 << k) + 1][k]);
}
La funzione lastRight trova la posizione più a destra t \in [\mathit{from}; e] tale che G(m, t) = g. Qui g = G(m, \mathit{from}). Poiché non aumenta al crescere di , l'uguaglianza vale su una parte iniziale del segmento , e la ricerca binaria ne trova l'ultima posizione. Il punto medio si calcola come (\mathit{lo} + \mathit{hi} + 1) / 2, affinché la ricerca non si blocchi sull'assegnazione \mathit{lo} = \mathit{mid}.
int lastRight(int m, int from, int e, int g)
{
  int lo = from, hi = e;
  while (lo < hi)
  {
    int mid = (lo + hi + 1) / 2;
    if (qGcd(m, mid) == g) lo = mid; else hi = mid - 1;
  }
  return lo;
}La funzione firstLeft trova in modo simmetrico la posizione più a sinistra t \in [b; \mathit{from}] tale che G(t, m) = g.
int firstLeft(int m, int from, int b, int g)
{
  int lo = b, hi = from;
  while (lo < hi)
  {
    int mid = (lo + hi) / 2;
    if (qGcd(mid, m) == g) hi = mid; else lo = mid + 1;
  }
  return lo;
}La struttura Group descrive un gruppo di estremi dei segmenti:
— il valore del MCD,
— il numero di posizioni nel gruppo.
struct Group { int g; ll cnt; };La funzione solve restituisce, modulo , la somma di P(i, j) su tutti i segmenti contenuti in . Per un segmento vuoto la somma è .
ll solve(int b, int e)
{
  if (b > e) return 0;
Troviamo la posizione dell'elemento massimo su .
int m = qMax(b, e);Suddividiamo gli estremi destri j = m, m + 1, \ldots, e in gruppi. Per il corrente calcoliamo g = G(m, j) e con la funzione lastRight troviamo l'ultima posizione del gruppo. Il gruppo contiene t - j + 1 posizioni; il gruppo successivo inizia nella posizione t + 1.
  vector<Group> R;
  for (int j = m; j <= e; )
  {
    int g = qGcd(m, j);
    int t = lastRight(m, j, e, g);
    R.push_back({ g, t - j + 1 });
    j = t + 1;
}Analogamente suddividiamo in gruppi gli estremi sinistri i = m, m - 1, \ldots, b. Il gruppo occupa le posizioni da a e contiene i - t + 1 posizioni; il gruppo successivo termina nella posizione t - 1.
  vector<Group> L;
  for (int i = m; i >= b; )
  {
    int g = qGcd(i, m);
    int t = firstLeft(m, i, b, g);
    L.push_back({ g, i - t + 1 });
    i = t - 1;
}Calcoliamo la somma dei valori del MCD su tutti i segmenti che contengono la posizione . Per ogni coppia di gruppi aggiungiamo \gcd(l.g, r.g) \cdot l.\mathit{cnt} \cdot r.\mathit{cnt}. Il prodotto l.\mathit{cnt} \cdot r.\mathit{cnt} non supera 4 \cdot 10^{10} e rientra nel tipo long long. Lo riduciamo modulo ; dopodiché anche il prodotto del MCD (minore di 2^{30}) per un numero minore di rientra in long long.
  ll sumG = 0;
  for (Group &l : L)
    for (Group &r : R)
    {
      ll cnt = (l.cnt * r.cnt) % MOD;
      sumG = (sumG + gcd(l.g, r.g) % MOD * cnt) % MOD;
}Il massimo su tutti i segmenti che contengono è pari ad a_m, quindi il loro contributo totale è a_m \cdot \mathit{sumG}.
ll res = (ll)a[m] % MOD * sumG % MOD;Aggiungiamo le somme calcolate ricorsivamente per i segmenti situati interamente a sinistra e a destra della posizione .
  return (res + solve(b, m - 1) + solve(m + 1, e)) % MOD;
}
Parte principale del programma. Leggiamo i dati di input.
scanf("%d", &n);
a.resize(n);
for (int &x : a) scanf("%d", &x);
Costruiamo le sparse table.
build();Stampiamo la risposta per l'intero array — il segmento [0; n - 1].
printf("%lld\n", solve(0, n - 1));